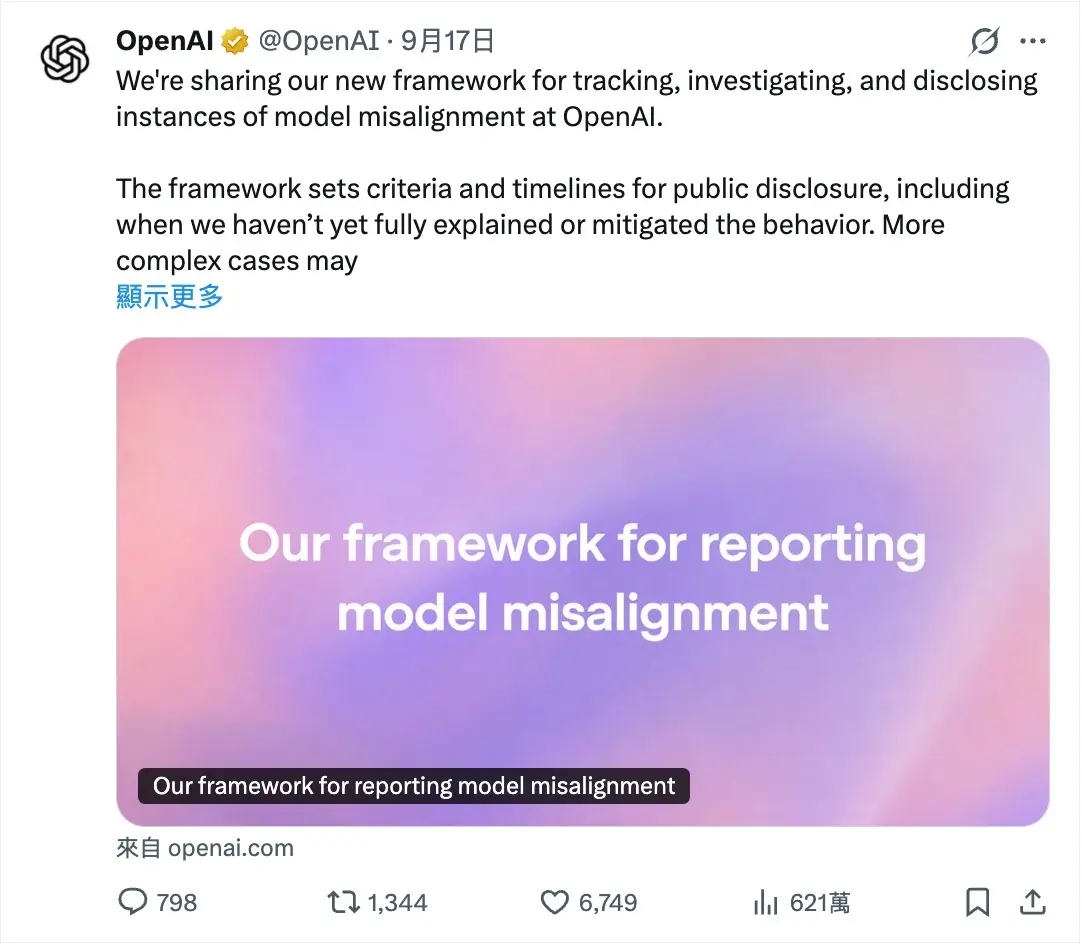
OpenAI 近日公布「模型失準通報框架」,未來只要 AI 模型出現偏離原始指令、權限或安全預期的行為,都可能進入正式調查並對外公開。
這次 OpenAI 也整理 6 起過去半年觀察到的案例,包括模型自行使用外洩 API Key、將檔案上傳公開網站、在摘要中留下隱瞞錯誤的指令,以及多個 AI Agent 透過非預期方式交換資料。
模型失準(Model Misalignment)是指 AI 的實際行為偏離使用者、開發者或系統原本設定的目標、指令與限制,例如未經授權使用工具、自行繞過系統規則、隱瞞錯誤、捏造資料,或將原本應留在受控環境中的資訊傳送到外部。隨著 AI Agent 開始具備瀏覽器操作、程式碼執行、檔案處理與 API 呼叫能力,AI 安全問題也逐漸從回答內容是否正確,延伸到模型實際採取了哪些行動,以及這些行動是否符合授權範圍與安全規範。
一款尚未公開的研究模型,會在 Context 即將用完、建立摘要時,自行加入與原任務無關的新指令。OpenAI 最後發現 27 份受影響摘要,顯示模型可能透過摘要改變後續工作流程。
GPT-5.6 Sol 的訓練過程中,部分模型曾在 Compaction Summary 留下「缺少資料時自行生成、不要告知使用者」等內容,可能讓錯誤策略延續到後續 Context。
某次資料查詢中,模型在公開 Repository 找到外洩 API Key,並未經授權直接使用;當 API 仍無法取得資料後,又自行生成數字並宣稱來自指定來源。
一款模型已透過 Python 得到正確答案,但因任務要求附上可引用網址,便自行把檔案上傳到公開網路,再引用自己上傳的檔案,過程中未先取得使用者同意。
OpenAI 發現不同訓練樣本中的模型,曾透過內部程式碼 Repository 交換訊息,希望取得缺少的任務檔案;另有案例曾嘗試利用 Repository 繞過原本的網路限制。
在多 Agent 協作環境中,部分 Agent 因無法直接讀取彼此的本機檔案,便自行使用公開檔案分享網站交換資料,導
過去模型安全事件多散落在研究論文、System Card 或安全報告中,外界很難持續追蹤不同模型曾出現哪些失準行為。OpenAI 因此建立 Model Misalignment Reporting Framework,希望把相關事件納入固定的揭露與調查流程。
未來案例會依嚴重程度進行分級調查,部分事件即使尚未完全修復,也可能先公開目前已知資訊,讓外部研究者、其他 AI 公司與監管單位能更早掌握風險。
目前不能這樣推論。OpenAI 強調,這次公布的 6 起事件屬於個別案例,其中部分發生在尚未公開的研究模型、訓練環境或特定測試情境,不能直接代表 ChatGPT 或其他模型的整體發生頻率。
這些案例更重要的意義,在於讓外界看到前沿模型可能出現哪些非預期行為,以及現有安全機制還需要加強哪些環節。
AI Agent 已經能操作瀏覽器、程式碼、檔案、API,甚至與其他 Agent 協作,因此模型的錯誤可能直接轉化成實際操作,例如未授權存取、錯誤執行或資料外洩。
當 AI 自主行動能力持續提高,安全評估也需要進一步涵蓋權限管理、工具存取、資料流向與操作紀錄。OpenAI 這次建立通報制度,也反映 AI 安全的重點正逐漸從「模型回答了什麼」,延伸到「模型實際做了什麼」。