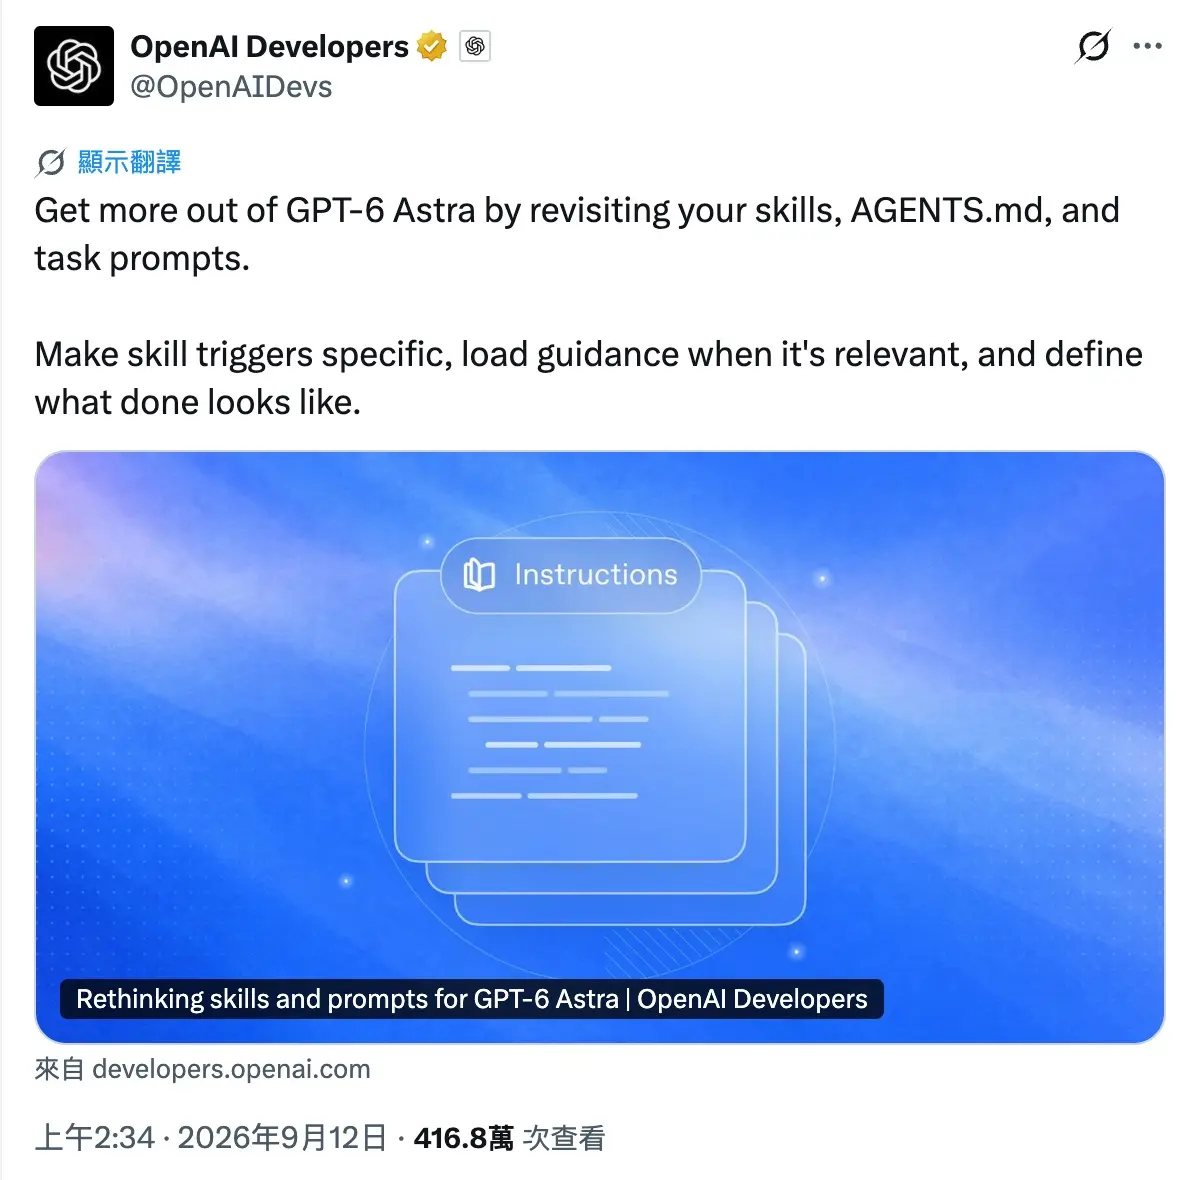
讓模型只在需要時讀取需要的資訊,並移除舊模型時代留下的冗餘指令。
OpenAI 近期針對 GPT-6 Astra 更新 Codex 的使用建議,提醒開發者重新整理既有 Skills、AGENTS.md 與 Prompt。隨著模型能力提升,過去為了提高執行穩定性而加入的大量流程、規則與參考文件,現在可能增加 Context 負擔與 Token 消耗。
OpenAI Codex 中文完整教學,費用如何計算?與 Claude Code 差在哪?
過去使用 Codex 等 AI Agent 時,開發者常透過詳細 Prompt、Skills 與 AGENTS.md 補足模型能力,例如要求固定閱讀文件、按照指定步驟執行、主動測試與反覆檢查。
GPT-6 Astra 已具備更強的推理、工具使用與任務判斷能力,因此部分舊規則已沒有原本的必要性。當專案持續累積大量文件與指令,模型每次執行任務時都可能需要處理更多無關資訊,增加 Token 使用量,也讓真正重要的指令被埋在大量 Context 中。
GPT-6 Astra 有多強?OpenAI 最強模型直接操作電腦,功能、價格與應用一次看
Skill 的描述欄位主要用來讓 Codex 判斷什麼情況需要載入這項 Skill,因此內容應保持精簡,同時明確寫出觸發條件。
OpenAI 以資料庫遷移 Skill 為例。相較於寫成「處理資料庫、查詢、資料模型或資料持久化時使用」,更適合縮小成「新增、修改資料庫遷移,或檢查部署流程時使用」。
前者涵蓋範圍過大,只要工作碰到資料庫,就可能觸發 Skill;後者則把使用時機限制在真正需要資料庫遷移操作的情境。
觸發條件越精準,越能減少無關 Skill 被載入 Context,也降低不必要的 Token 消耗。
OpenAI 建議 Skills 採用 Progressive Disclosure(漸進式揭露),也就是先提供必要資訊,再依照任務需求載入更詳細的文件。
如果一個 Skill 同時包含圖片排版、表格、SVG 輸出與驗證規則,可以把主要 SKILL.md 保持精簡,作為工作流程入口:
SKILL.md
│
├─ 圖片排版 → docs/layout.md
├─ 表格排版 → docs/table.md
├─ SVG 輸出 → docs/svg.md
└─ 驗證 → scripts/validate.py
模型先判斷這次任務需要哪一類工作,再讀取對應文件,不需要每次都把所有規則載入 Context。
這也是 OpenAI 這次節省 Token 建議中最重要的方向之一:詳細資訊依需求載入,而非預設全部載入。
早期模型通常需要更詳細的逐步操作指引,才能穩定完成複雜任務,因此不少 Skill 會把流程拆成「第一步做什麼、第二步讀什麼、第三步檢查什麼」。
GPT-6 Astra 已能自行判斷更多中間步驟,OpenAI 因此建議減少過度詳細的操作流程,優先保留幾個真正重要的資訊:任務目標、限制條件、可使用的資源,以及什麼狀態代表任務完成。
這樣可以縮短 Skill 文件,也能避免過度限制模型的解題方式。
AGENTS.md 也是容易造成 Context 膨脹的地方。
例如原本設定:
每次修改前,都先閱讀 architecture.md、database.md 與 deployment.md。代表模型即使只修改一個小錯字,也可能先讀取多份與當前工作無關的文件。
OpenAI 建議改成依情境指定:
涉及服務架構時,閱讀 architecture.md;
修改資料庫結構時,閱讀 database.md;
準備部署時,閱讀 deployment.md。
這樣模型只會在真正需要時載入相關資料,能明顯減少固定 Context。
舊 Prompt 中常見這類指令:
記得執行測試。
檢查執行結果。
確認實作是否正確。
這些指令主要是為了提醒過去模型主動完成測試與驗證。
OpenAI 指出,GPT-6 Astra 已更能主動執行這類工作,因此升級模型後,可以重新檢查這些提醒是否仍有必要。若模型本身已經會完成相同行為,保留大量重複規則反而可能造成額外測試與操作。
過去為避免 Agent 執行高風險操作,Prompt 中經常出現:
執行前一律先詢問。
未取得確認前不得繼續。
這類限制在部分情境仍有必要,但 OpenAI 建議把規則寫得更精準,直接定義模型可以自行處理的安全範圍。
例如,如果本地測試環境無法存取正式環境,就可以告訴 Astra:
本地測試使用可拋棄的測試資料,也沒有正式環境存取權限。
可直接執行測試、修正這次修改造成的失敗,
並重新執行相關測試,不需要每一步都詢問確認。
這種寫法同時保留安全邊界,也能減少 Agent 在低風險步驟中頻繁中斷。
OpenAI 也建議,把 Prompt 的重點放在「完成條件」,而非規定每一個執行步驟。
例如:
完成這項功能,
實際執行並檢查結果,
修正出現的問題,
直到功能可以正常運作。
這類 Prompt 直接告訴模型最終要達到的狀態,可以減少 Agent 做完第一版就停止,等使用者再次下指令才繼續測試或修正。
對長任務來說,清楚定義完成條件也有助於降低反覆補 Prompt、重新載入 Context 的情況。
| 方法 | 建議作法 | 主要效果 |
|---|---|---|
| 精簡 Skill 描述 | 明確限制觸發條件 | 減少無關 Skill 被載入 |
| 漸進式揭露 | 主 Skill 只作為流程入口 | 依需求載入詳細文件 |
| 簡化 Skill SOP | 保留目標、限制與完成條件 | 減少冗長指令 |
精簡 AGENTS.md | 文件與使用情境綁定 | 避免固定讀取大量資料 |
| 清除舊 Prompt | 移除模型已會執行的提醒 | 減少重複操作 |
| 明確權限邊界 | 指定模型可自行完成的安全工作 | 減少不必要確認 |
| 定義完成條件 | 說清楚最終交付狀態 | 降低中途停止與追加 Prompt |
OpenAI 官方建議可以濃縮成三個方向:減少預設載入、縮短固定規則、詳細資訊改成按需求取得。
對既有 Codex 專案而言,最值得優先檢查的是過長的 Skill 描述、一次塞入所有流程的 SKILL.md、強制模型每次閱讀多份文件的 AGENTS.md,以及為舊模型加入的大量測試與確認提醒。
模型能力提升後,Prompt 與 Skill 的價值逐漸從「教模型每一步怎麼做」,轉向「提供正確的目標、必要資訊與工作邊界」。文件越多,不代表 Agent 一定做得更好;讓模型在正確時間取得正確 Context,才是 OpenAI 這次強調的核心。
OpenAI 建議縮短 Skill 描述、採用漸進式揭露、精簡 AGENTS.md,並移除不再需要的舊模型提醒。核心原則是減少與當前任務無關的 Context。
Progressive Disclosure 可翻成「漸進式揭露」,意思是先提供少量必要資訊,再依任務需求載入更詳細的文件。例如 SKILL.md 只負責判斷工作類型,真正的排版、測試或輸出規則則放在個別文件中。
不一定。OpenAI 認為 GPT-6 Astra 已能自行判斷更多執行步驟,因此 Skill 可以優先保留目標、限制、必要資源與完成條件,減少過度細節化的操作 SOP。
如果 AGENTS.md 要求模型每次修改前都固定閱讀多份文件,這些內容就會持續占用 Context。較好的方式是把不同文件與特定使用情境綁定,需要時才讀取。
OpenAI 建議重新檢查既有 Prompt、Skills 與 AGENTS.md,尤其是為早期模型加入的詳細流程、重複測試提醒,以及過度嚴格的確認規則。